La codifica per caratteri che si è imposta come standard di fatto
nell'informatica fino dagli anni '80 è la
codifica ASCII.
La codifica ASCII (American Standard Code for Information Interchange)
prevede una tabella di 256 caratteri (codifica a 8 bit),
di cui però
solo la parte bassa (col bit più significativo a zero)
era considerata "internazionale", nel senso che in tutto il mondo
dava luogo a una stessa rappresentazione in caratteri, mentre la parte alta
(codici da 128 a 255) aveva invece differenti interpretazioni a
seconda della scelta di localizzazione.
Lo standard Unicode è nato anche per superare questo tipo di
problemi. Per prima cosa oggi si riconosce come legittima solo la parte bassa
della codifica ASCII (7 bit) a cui si preferisce dare il nome di codifica
US_ASCII.
Il set di caratteri (o meglio un suo ragionevole sottoinsieme)
presenti nella codifica US-ASCII è
quello usato nei protocolli a livello applicativo in uso nell'Internet e la sua
definizione all'interno dello standard Unicode è fornito nella seguente
tabella:

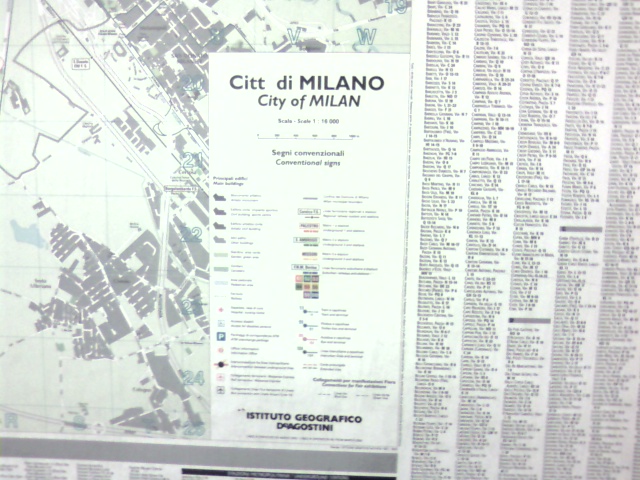
Dimenticare le limitazioni di codifica della parte internazionale
della tabella ASCII può portare a diversi inconvenienti:
dalla presenza di caratteri illeggibili all'interno di messaggi di posta
elettronica e pagine web, a effetti spiacevoli come quello che si può
osservare in un'edizione delle mappe di Milano presenti nelle stazioni della
metropolitana: